前陣子看 Railway 的用量明細,記憶體是裡面最大的一項。我想把用量降下來,但產品已經有正式使用者,需要全天在線,也要保留目前的處理量。讓服務休眠、減少同時能處理的工作,都不符合這次的需求。
這個產品叫 SpeakCanada,是一個 AI 法文口說練習工具。使用者錄下一段回答,後端把錄音轉成文字,再交給 AI 考官根據內容追問,最後把對話存起來。
順著這條流程看,錄音的用途其實滿清楚:轉錄時需要它。到了這篇討論的考官追問流程,用的已經是文字。
但這次沿著資料往下查,發現轉錄完成後,原始錄音還可能一路留到 AI 回覆。後面的工作已經用不到它,等待中的函式卻還留著指向錄音的變數。
被呼叫的函式在跑,呼叫它的函式也還沒結束
開始練習時,這段程式會經過兩個函式。一個負責開始這場練習,再呼叫另一個函式,由它處理轉錄、考官回覆和儲存結果。
把呼叫者叫 A,被呼叫的函式叫 B,就是 A 請 B 做一部分工作,等 B 做完再拿回結果。兩個函式都在同一個後端,程式碼不必寫在一起,也不必放在同一個檔案。「外層、內層」在這裡只是在描述誰呼叫誰,直接看下面的執行順序比較清楚。
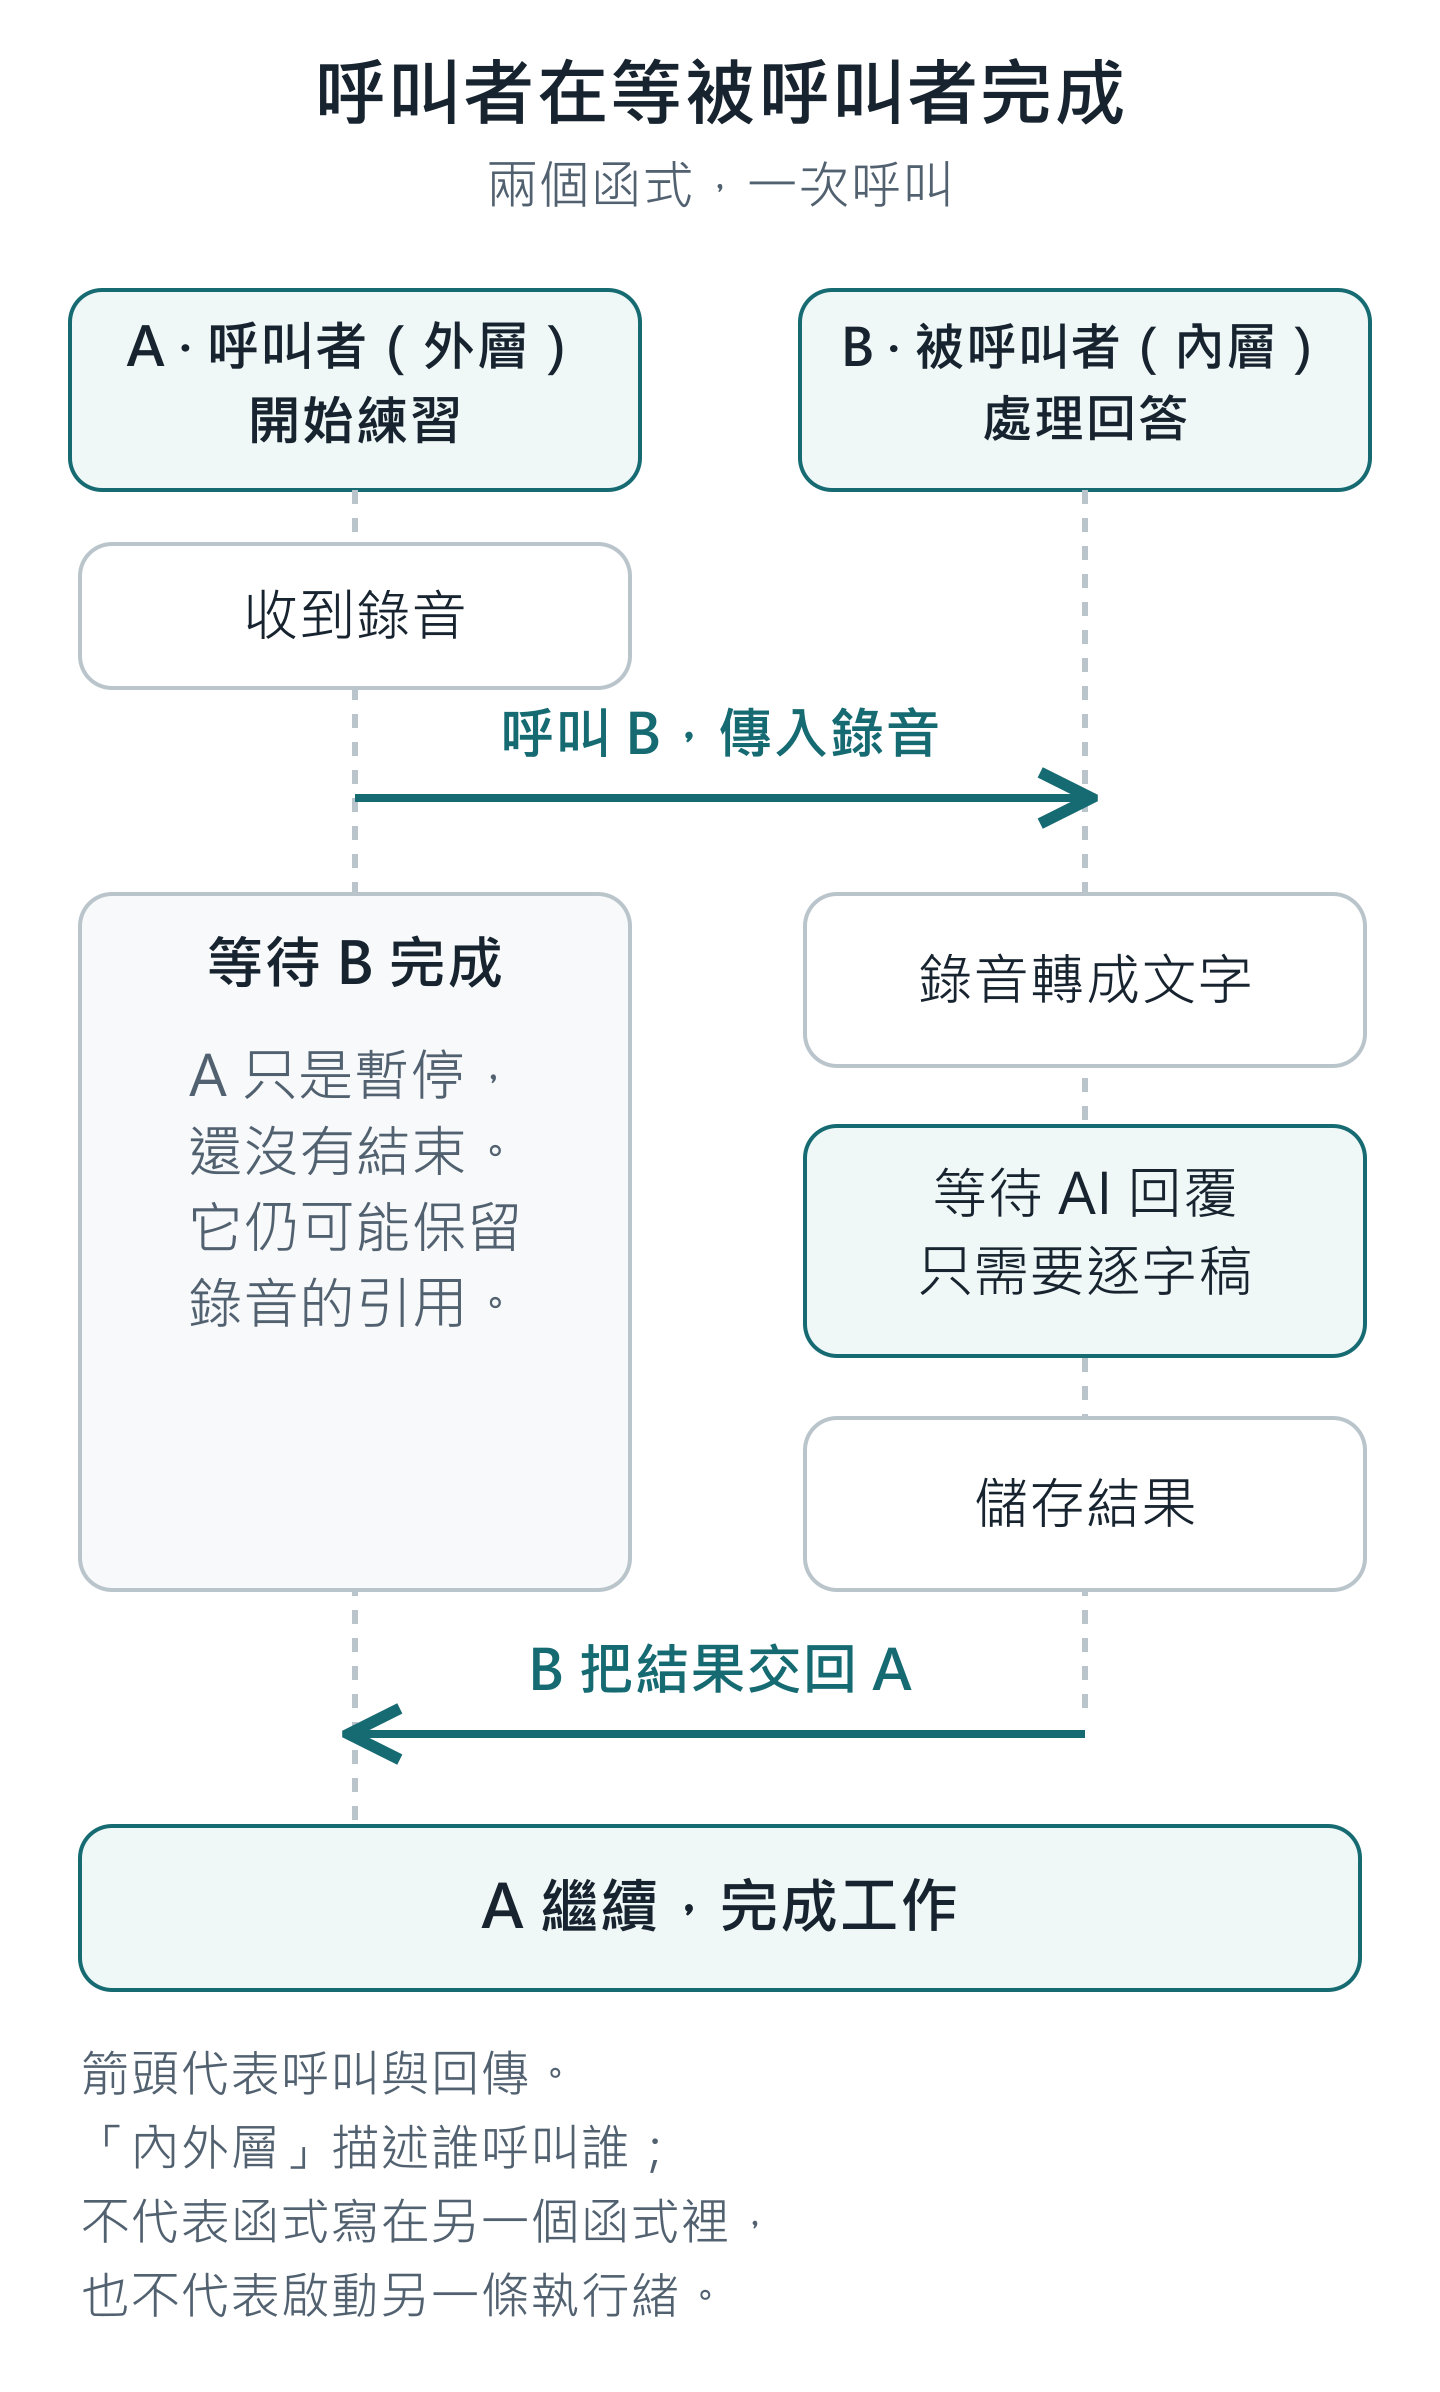
A 在等 B,並不代表 A 已經結束。A 裡面的區域變數,也不會因為開始等待就自動消失。
把原本的程式簡化,大概長這樣:
async def start_session(audio):
    return await process_answer(audio)

async def process_answer(audio):
    transcript = await transcribe(audio)
    reply = await ask_examiner(transcript)
    await save_result(transcript, reply)
    return reply
程式走到 ask_examiner,開始等考官時,兩個函式都還可能留著 audio。這裡傳遞參數不會複製一份錄音,是兩個引用指向同一份資料。
所以只拿掉 process_answer 裡面的引用還不夠。start_session 還沒結束,只要它仍留著自己的引用,這份錄音就還不能回收。
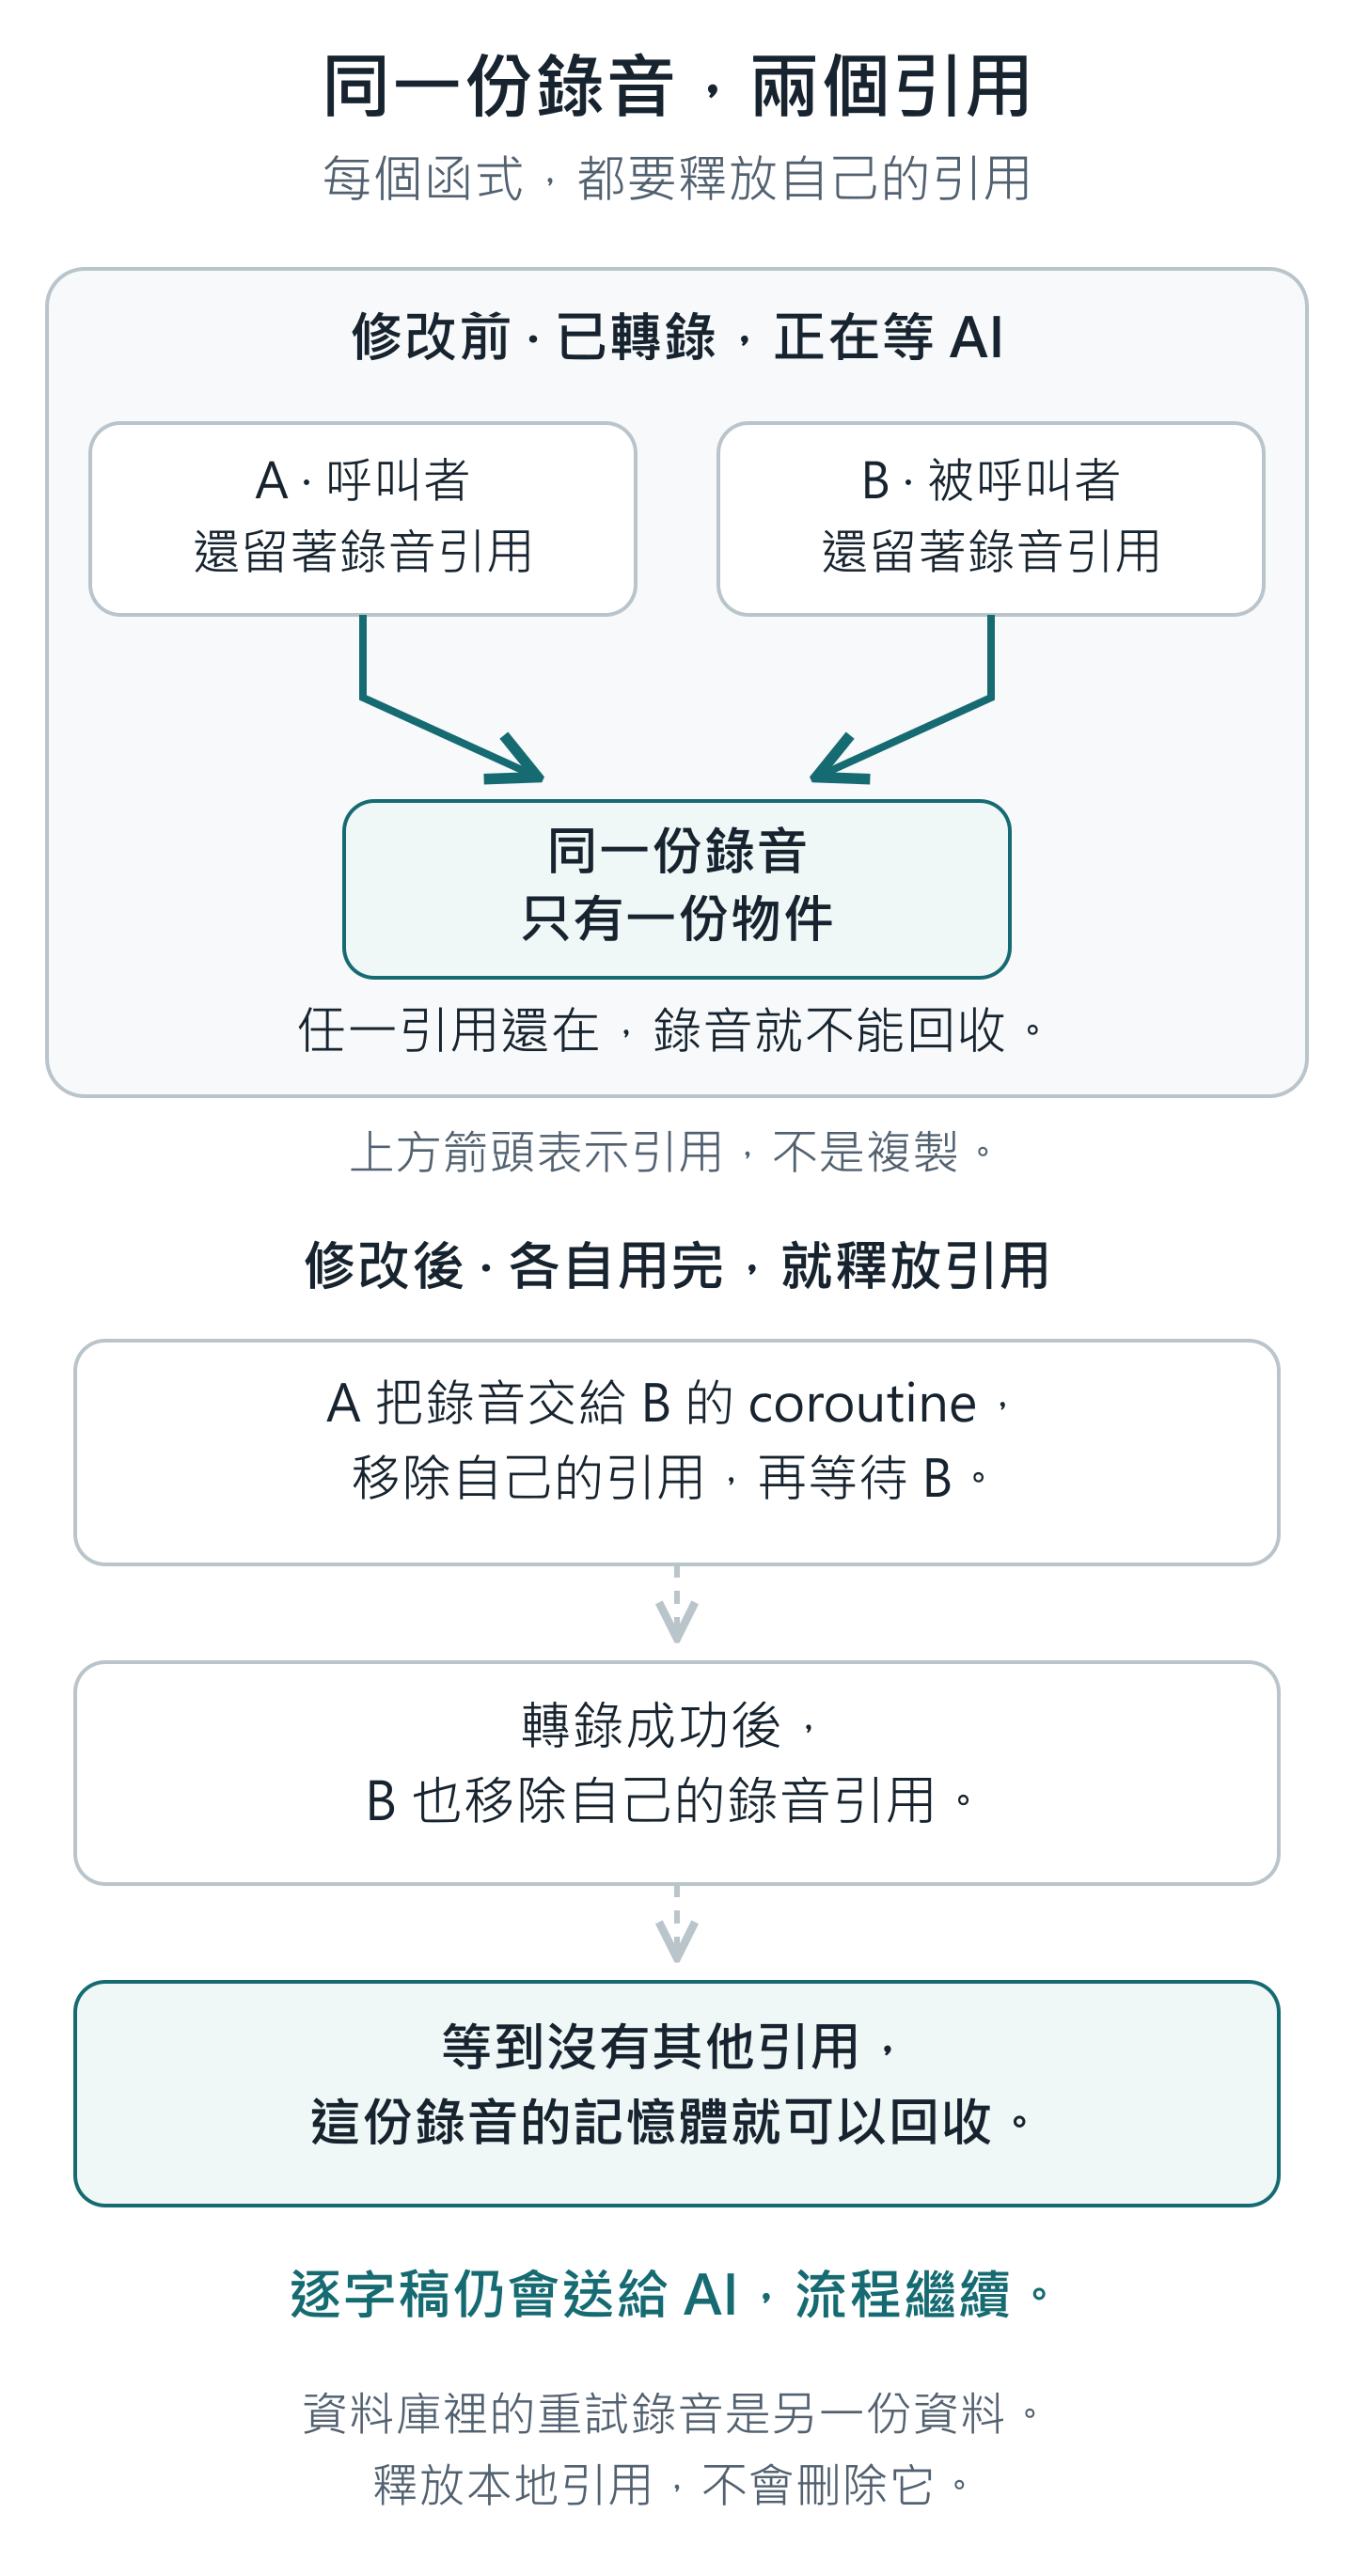
箭頭代表引用,不代表錄音被複製。拿掉記憶體裡的引用,也不等於刪除資料庫中的重試錄音。
修改後的結構是這樣:
async def start_session(audio):
    operation = process_answer(audio)
    del audio
    return await operation

async def process_answer(audio):
    transcript = await transcribe(audio)
    del audio
    reply = await ask_examiner(transcript)
    await save_result(transcript, reply)
    return reply
呼叫 async 函式時,會先建立一個 coroutine,參數已經交給它保留。呼叫者接著移除自己的 audio 引用,再立刻等待同一個 coroutine。這裡沒有另開背景 task,也沒有增加並行工作。
處理回答的函式則等轉錄成功,才移除自己的引用。往上追,worker 和 dispatcher 原本就有做引用交接;轉錄 helper 成功回傳時,它自己對清理後音訊的區域引用也會離開作用域。這次補的是開始練習與追問路徑中,還留著原始錄音的地方。
不過,del 做的是移除引用,不能把它解讀成作業系統看到的記憶體數字會立刻下降。
重試要用的錄音,還是得留
這裡還有另一份資料:佇列工作存在資料庫裡的加密錄音。處理失敗、需要重試時,靠的是這份持久化資料。
記憶體裡用完的 buffer 可以放掉,資料庫的重試來源則要照原本的終止清理流程保留。否則記憶體少了一點,遇到失敗卻再也沒辦法重跑,這個修改就不算成功。驗收條件也包含逐字稿、對話結果、重複請求,以及額度扣除與退回的行為不能改變。
這次的檢查用了真正的獨立 PostgreSQL 16.14 測試資料庫,跑應用程式本身的 migrations。音訊處理、語音辨識和 AI 考官都用替代實作。因此驗證範圍是 worker 到資料庫這段,沒有呼叫付費服務,也沒有拿它來證明辨識或考官的回答品質。
修改前,新加的成功路徑測試先確認對話和工作狀態寫入正確,接著有 8 個記憶體檢查失敗;另外 4 個最後一回合的案例原本就通過。用 3 個全新的 process 重跑,結果相同。套用修改後,同一批結果檢查和記憶體檢查都通過,沒有把預期值放寬。
相關回歸測試總共通過 177 個。新增案例包含服務失敗、取消和重播,但取消還有一個範圍要講清楚:開始練習時被取消的案例,確認了持久化資料仍可供 reconciliation 使用,沒有證明真正的 reconciler 搭配資料庫能自動走完重新啟動的恢復流程。
實際量到多少
量測用的是固定的 4 MiB 合成位元組資料,搭配共用或獨立的清理後 buffer。這是控制資料大小的配置測試,沒有拿真實錄音跑語音模型。
修改前後各用 3 個全新的 process 量測。在等待考官的時間點,各案例的 Python 追蹤存活 heap 中位數,從 4.05–4.38 MiB 降到 0.05–0.38 MiB,大約少留了一份 4 MiB 的原始 buffer。最初配置資料時的峰值,仍然約是 22.7–22.9 MiB。
量測摘要列了記錄下來的數字、測試設定,以及這次比較的限制。
這是目前能說的結果。它沒有證明正式環境的 RSS 下降、容量增加,或 Railway 帳單變少。錄音在轉錄時還是得進記憶體;這次縮短的是轉錄完成後,繼續留著它的時間。
截至 2026 年 9 月 28 日,這份修改完成本地驗證,尚未 commit、合併或部署。真正的模型服務驗證和正式環境量測仍待完成,要等那些結果出來,才能往實際省下多少費用繼續看。
這次由 AI coding agents 協助追查引用、準備修改與測試、review,以及整理文章。我決定運作限制並要求驗證;上面的數字來自已記錄的本地測試。